تعرف إلى المصطلحات الأكثر شيوعاً في عالم الذكاء الاصطناعي
يعتمد العلماء العاملون في هذا المجال على مصطلحات فنية للاختصار

عالم الذكاء الاصطناعي عميق ومعقد، وغالباً ما يعتمد العلماء العاملون في هذا المجال على المصطلحات الفنية واللغة المتخصصة لشرح ما يعملون عليه، مما يضطرنا في تغطيتنا الإخبارية لصناعة الذكاء الاصطناعي إلى استخدام تلك المصطلحات التقنية.
لهذا السبب، رأينا في بلوك تِك أنه من المفيد إعداد مرجع يحتوي على تعريفات لأهم المصطلحات والعبارات التي نستخدمها بانتظام في مقالاتنا.
الذكاء الاصطناعي العام (AGI)
الذكاء الاصطناعي العام – Artificial general intelligence، أو AGI، هو مصطلح فضفاض، لكنه يشير عموماً إلى نوع من الذكاء الاصطناعي يتفوَّق على الإنسان العادي في العديد -إن لم يكن معظم- المهام.
“يعادل موظفًا بشريًا متوسط الكفاءة يمكن توظيفه للعمل إلى جانبك”
سام ألتمان
الرئيس التنفيذي لشركة أوبن أي آي
في وصف AGI
يُعرِّف ميثاق أوبن أي آي AGI على أنه “أنظمة مستقلة بدرجة عالية تتفوّق على البشر في أغلب الأعمال ذات القيمة الاقتصادية”.
أما شركة Google DeepMind فلها فهم مختلف قليلًا، إذ تعتبر AGI بمثابة “ذكاء اصطناعي يمتلك قدرات تعادل -على الأقل- قدرات الإنسان في معظم المهام الإدراكية.
هل تشعر بالارتباك؟
لا تقلق، حتى خبراء الذكاء الاصطناعي أنفسهم ما زالوا مختلفين في تعريفهم لهذا المفهوم.
الوكيل الذكي (AI Agent)
الوكيل الذكي هو أداة تعتمد على تقنيات الذكاء الاصطناعي لأداء سلسلة من المهام بالنيابة عن المستخدم -تتجاوز بكثير ما يمكن لروبوت دردشة تقليدي القيام به- مثل تقديم طلبات النفقات، حجز تذاكر السفر أو المطاعم، أو حتى كتابة الكود البرمجي وصيانته.
ومع ذلك، كما أوضحنا سابقاً؛ لا يزال هذا المجال الناشئ يتطور بسرعة، ومصطلح “الوكيل الذكي” قد يعني أشياء مختلفة لأشخاص مختلفين.
فالبنية التحتية التي تُمكِّن هذه الأنظمة من تنفيذ مهامها المتعددة لا تزال قيد البناء، لكن المفهوم الأساسي يُشير إلى نظام مستقل قد يعتمد على عدة نماذج ذكاء اصطناعي لتنفيذ مهام مركَّبة ومتعددة الخطوات.
سلسلة التفكير (Chain of Thought)
عندما يُطرح عليك سؤال بسيط مثل: “أي الحيوانات أطول، الزرافة أم القطة؟”، فإن عقلك البشري عادة ما يجيب بشكل فوري دون مجهود.
ولكن في مسائل أكثر تعقيداً مثل: إذا كان لدى مزارع عدد من الدجاجات والأبقار، ومجموع رؤوسها 40 ورجولها 120، فربما تحتاج إلى استخدام القلم والورقة لحل المعادلة والوصول إلى الإجابة (20 دجاجة و20 بقرة).
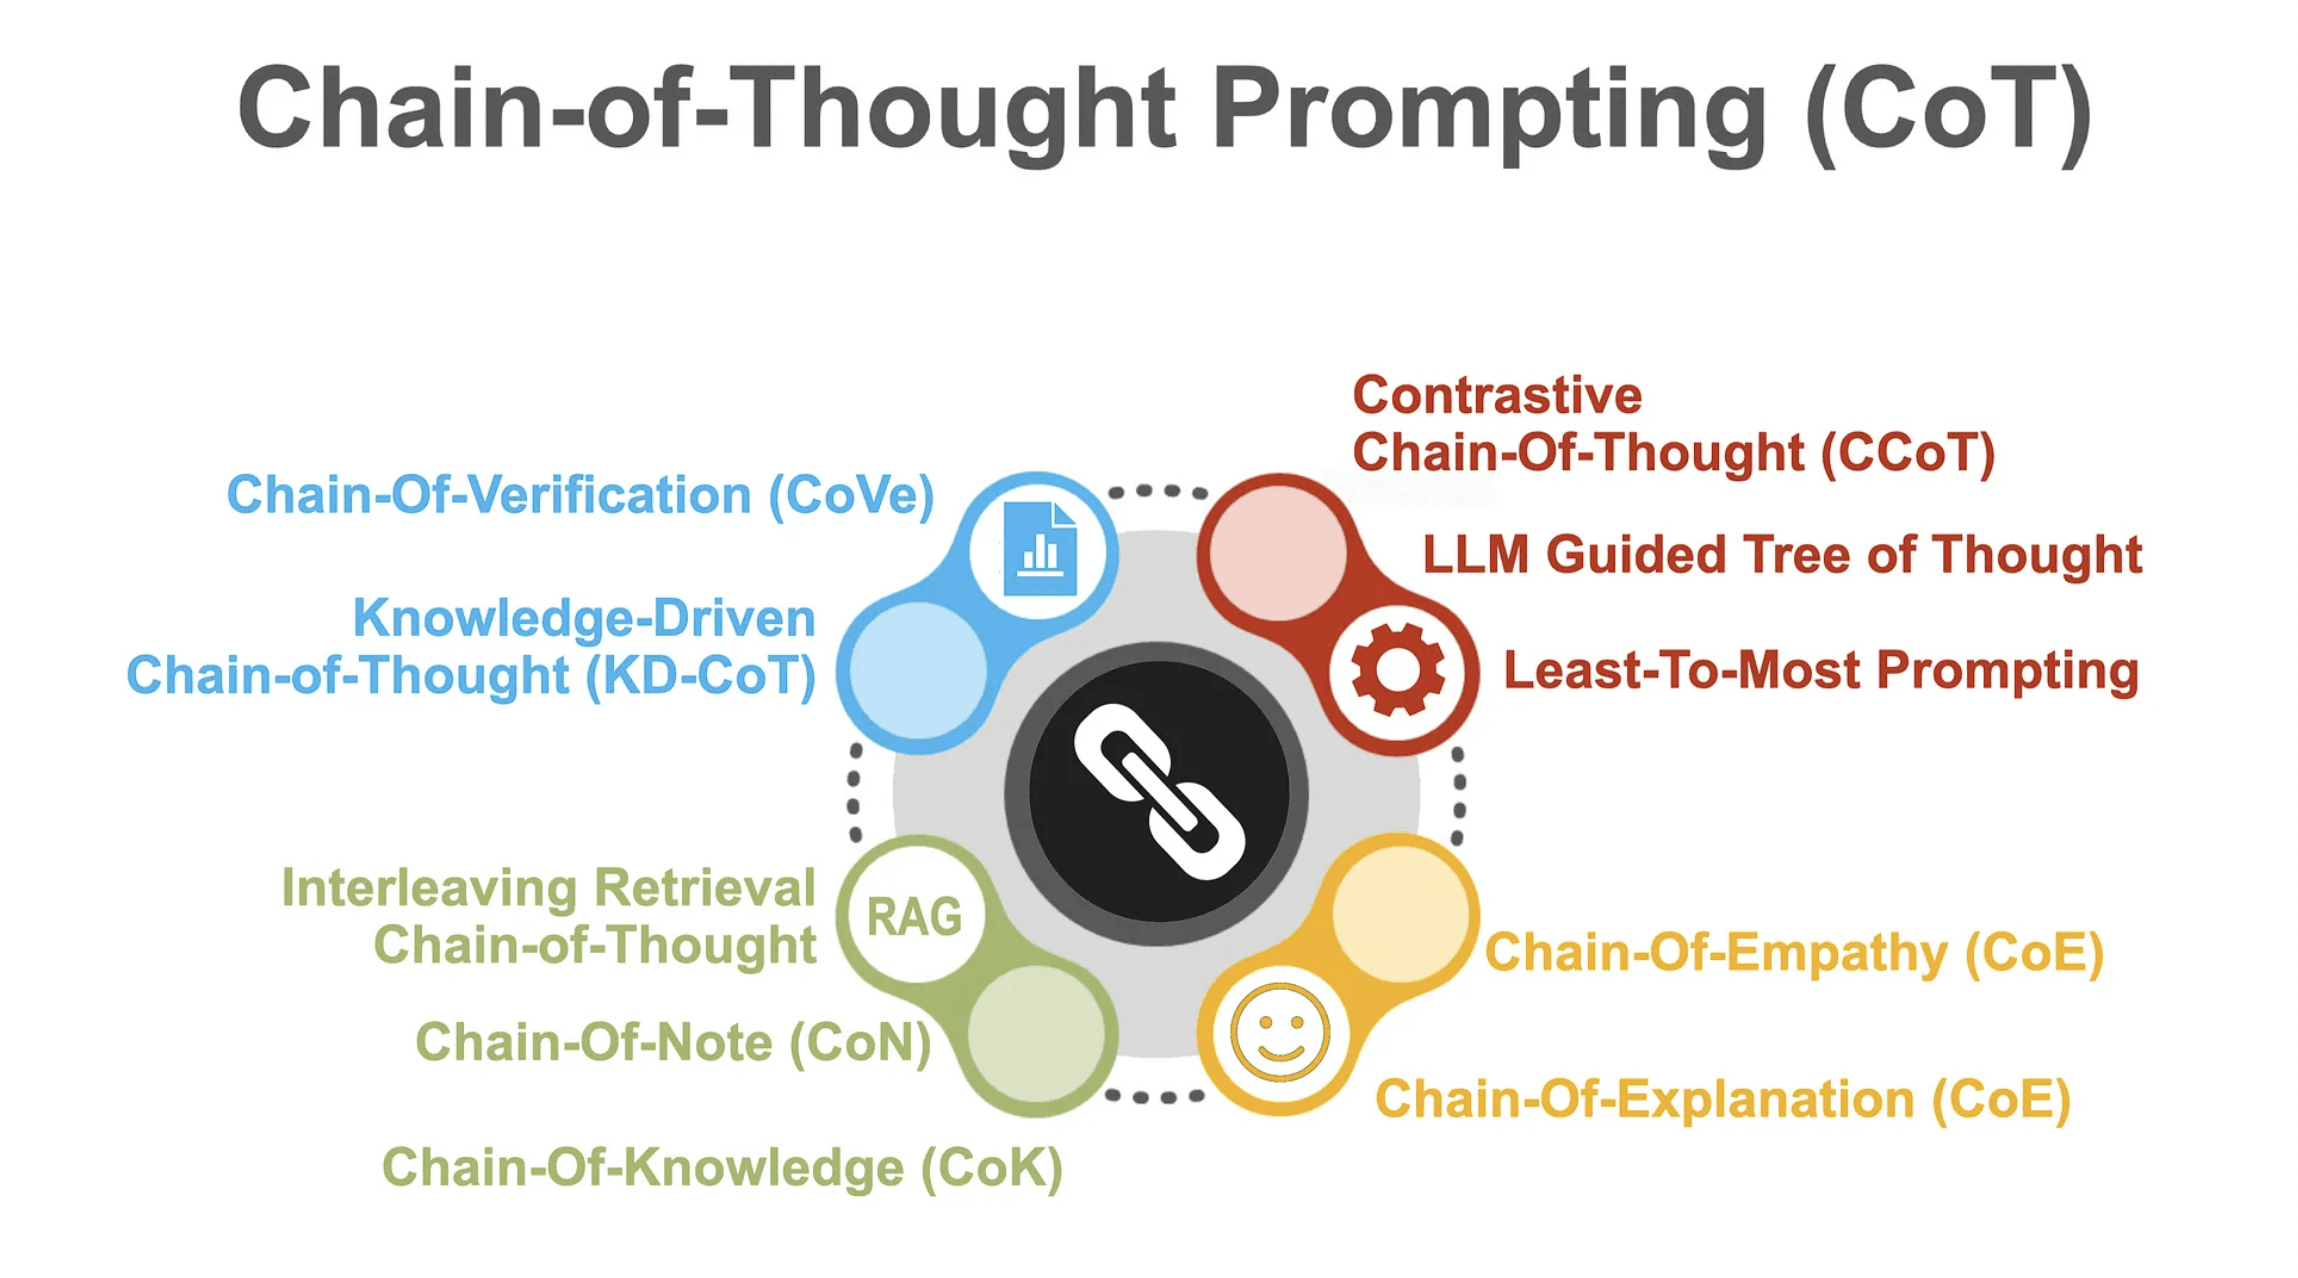
في سياق الذكاء الاصطناعي، تشير سلسلة التفكير إلى قدرة نماذج اللغة الكبيرة على تفكيك المسألة إلى خطوات وسيطة، أصغر، من أجل تحسين جودة الناتج النهائي.
هذه الطريقة تستغرق وقتاً أطول للحصول على الإجابة، لكنها غالباً ما تكون أدق، خاصة في المسائل المنطقية أو البرمجية.
وقد جرى تطوير نماذج التفكير المنطقي انطلاقاً من نماذج اللغة الكبيرة التقليدية، ثم جرى تحسينها باستخدام التعلم التعزيزي (Reinforcement Learning) لتكون أكثر قدرة على التفكير بطريقة “سلسلة الخطوات”.
التعلُّم العميق (Deep Learning)
يُعد أحد فروع التعلُّم الآلي ذاتي التطوُّر، ويتميَّز باستخدام بنية شبكات عصبية اصطناعية متعددة الطبقات، هذه البنية تُمكِّن نماذج الذكاء الاصطناعي من اكتشاف علاقات أكثر تعقيداً مقارنةً بالأنظمة التقليدية القائمة على التعلُّم الآلي، مثل النماذج الخطية أو أشجار القرار.
تستوحي خوارزميات التعلُّم العميق هيكلها من الترابطات العصبية في الدماغ البشري، ما يجعلها قادرة على التعرُّف على السمات المهمة في البيانات دون الحاجة إلى تدخُّل مباشر من المهندسين لتحديد هذه السمات مسبقاً.
كما تدعم هذه البنية خوارزميات يمكنها التعلُّم من الأخطاء، وتحسين أدائها من خلال التكرار والتعديل التدريجي، ومع ذلك، تتطلب هذه النماذج تتطلّب كميات ضخمة من البيانات (تصل إلى ملايين النقاط أو أكثر) لتحقيق نتائج فعالة، كما أن تدريبها يستغرق وقتاً أطول مقارنةً بالخوارزميات الأبسط، ما يرفع من تكاليف التطوير بشكل عام.

الانتشار (Diffusion)
الانتشار هو التقنية الأساسية التي تقوم عليها العديد من نماذج الذكاء الاصطناعي المستخدمة في إنتاج الصور والموسيقى والنصوص.
مستوحاة من مفاهيم فيزيائية؛ تعمل أنظمة الانتشار على “تفكيك” البنية الأصلية للبيانات، مثل الصور أو المقاطع الموسيقية، عن طريق إضافة ضوضاء تدريجية حتى تتلاشى البيانات تماماً.
في الفيزياء، يُعد الانتشار عملية تلقائية ولا يمكن عكسها، فمثلًا، لا يمكن إعادة مكعب سكر ذائب في القهوة إلى شكله الصلب.
لكن في سياق الذكاء الاصطناعي، تهدف أنظمة الانتشار إلى تعلُّم “عملية عكسية” تُعيد بناء البيانات الأصلية من الضوضاء، مما يمنح النموذج القدرة على توليد محتوى جديد يبدو واقعياً.
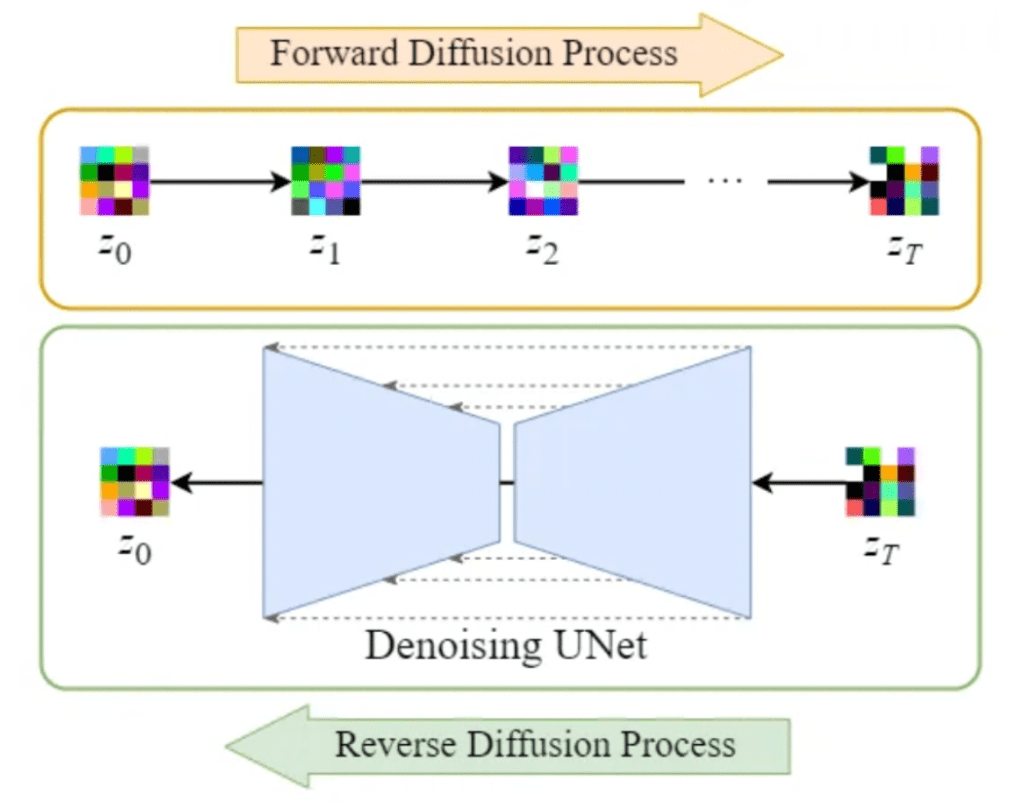
التقطير (Distillation)
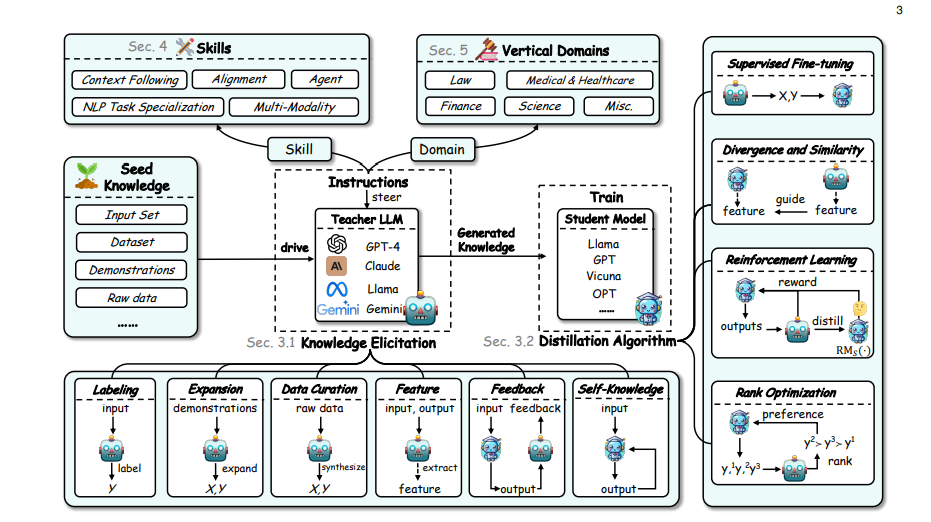
تقنية تُستخدم لاستخلاص المعرفة من نموذج ذكاء اصطناعي كبير باستخدام نموذج “المُعلِّم – الطالب”.
في هذه التقنية، يتم إرسال استفسارات إلى نموذج المعلم وتسجيل مخرجاته، والتي تُقارن أحياناً مع بيانات مرجعية للتحقق من دقتها.
ثم تُستخدم هذه المخرجات في تدريب نموذج الطالب، الذي يسعى إلى محاكاة سلوك المعلم بأكبر قدر ممكن من الدقة.
يُستخدم التقطير عادةً لإنشاء نموذج أصغر وأكفأ، يعتمد على نموذج أكبر، مع الحفاظ على أقل خسارة ممكنة في الدقة، فيما يُعتقد أن هذه الطريقة التي مكّّنت أوبن أي آي من تطوير النسخة الأسرع GPT-4 Turbo.
تستخدم جميع شركات الذكاء الاصطناعي الكبرى التقطير داخلياً، لكن يُرجَّح أن بعض الشركات قد استخدمته أيضاً في محاولة اللحاق بالنماذج المتقدِّمة لدى المنافسين، وهو ما يُعد خرقاً لشروط استخدام واجهات برمجة التطبيقات الخاصة بهذه النماذج.
التدريب الدقيق (Fine-tuning)
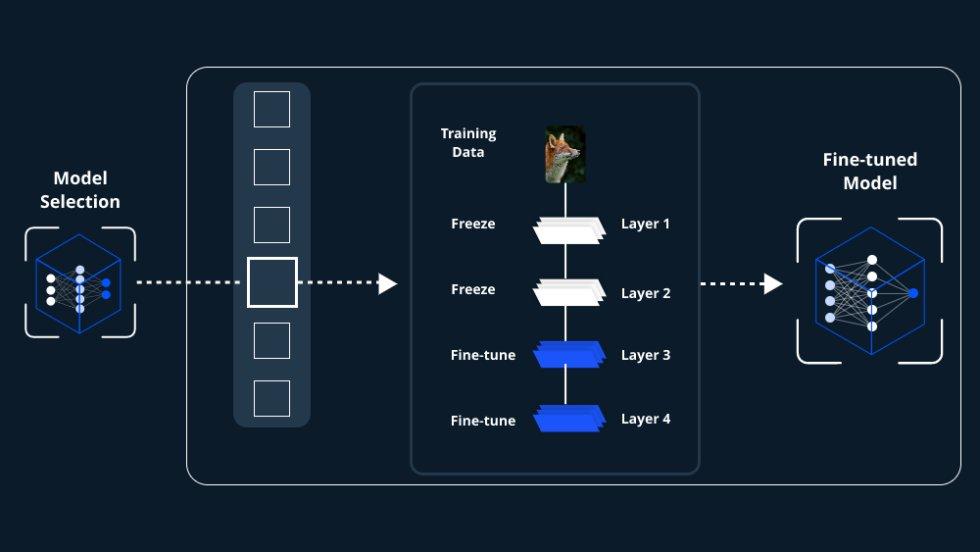
يشير المُصطلح إلى إعادة تدريب نموذج ذكاء اصطناعي بهدف تحسين أداءه في مهمة محددة، أو مجال تخصصي أكثر دقة مما تم تدريبه عليه سابقاً، ويجري ذلك عادةً من خلال إدخال بيانات جديدة موجَّهة نحو مهمة معينة.
تسعى العديد من الشركات الناشئة في مجال الذكاء الاصطناعي إلى الاستفادة من النماذج اللُغوية الكبيرة كنقطة انطلاق لبناء منتجات تجارية، ثم تقوم بتخصيصها بشكل أكبر عبر التدريب الدقيق باستخدام بيانات ومعرفة متخصصة في مجالات معينة.
الشبكات التوليدية التنافسية (GAN)
شبكة GAN، أو الشبكة التوليدية التنافسية، هي إطار تعلُّم آلي لعب دوراً أساسياً في تطوُّر الذكاء الاصطناعي التوليدي، لا سيما في إنتاج بيانات واقعية، بما في ذلك أدوات التزييف العميق – Deepfakes.
تعتمد GAN على وجود شبكتين عصبيتين:
- الأولى تُعرف باسم “المولِّد”، وتتعلم من بيانات التدريب لإنتاج مخرجات جديدة.
- أما الثانية، فهي “المميِّز”، وتقوم بتقييم هذه المخرجات ومحاولة تمييز ما إذا كانت حقيقية أم مُولَّدة.
يعمل هذا الإطار كمنافسة (ومن هنا جاءت تسمية “تنافسية”) بين النموذجين:
- يحاول المولِّد خداع المميِّز بمخرجاته
- بينما يعمل المميِّز على كشف المخرجات الزائفة.
هذه المنافسة الهيكلية تساعد على تحسين جودة المخرجات بشكل تدريجي، دون الحاجة إلى تدخل بشري كبير.
ومع أن GANs تُظهر أداءً متميزاً في تطبيقات محددة، مثل إنتاج الصور أو مقاطع الفيديو الواقعية، لكنها غير مثالية للاستخدامات العامة في الذكاء الاصطناعي.

الهلوسة (Hallucination)
الهلوسة هي المصطلح المُفضَّل في صناعة الذكاء الاصطناعي للإشارة إلى ظاهرة “اختلاق” النماذج لمعلومات غير صحيحة، أي توليد بيانات أو إجابات غير دقيقة أو لا تمت للواقع بصلة.
ومن الواضح أن هذه المشكلة تمثل تحدياً كبيراً لجودة وأمان أنظمة الذكاء الاصطناعي التوليدي (GenAI).
تُنتِج الهلوسات مخرجات من نماذج الذكاء الاصطناعي التوليدي قد تكون مضللة، بل وقد تؤدي في بعض الأحيان إلى عواقب خطيرة في الواقع، كأن يقوم المستخدم بطرح استفسار طبي فيحصل على نصيحة ضارَّة صحياً.
لهذا السبب، تُدرج معظم أدوات GenAI تحذيرات في الشروط والأحكام تطلب من المستخدمين التحقق من صحة الإجابات التي تُقدِّمها النماذج، مع التحفظ على هذه التحذيرات التي عادة ما تكون أقل وضوحاً من المعلومات التي تُعرض بلمسة زر.
يُعتقد أن مشكلة اختلاق المعلومات من قبل الذكاء الاصطناعي تعود في أصلها إلى فجوات في البيانات التي تم تدريب النموذج عليها، وهذا التحدي يُعتبر أكثر بروزاً في النماذج التوليدية العامة، والتي تُعرف أيضاً باسم نماذج الأساس – Foundation Models.
ببساطة، لا توجد كمية بيانات كافية في العالم اليوم لتدريب نماذج ذكاء اصطناعي يمكنها الإجابة بدقة على كل سؤال ممكن.
هذه المعضلة دفعت باتجاه تطوير نماذج ذكاء اصطناعي أكثر تخصصاً أو عمودية، أي نماذج موجَّهة لمجالات محددة تتطلب معرفة أضيق وأكثر تركيزاً، بهدف تقليص فجوات المعرفة وتقليل احتمالية انتشار المعلومات المضللة.

الاستدلال (Inference)
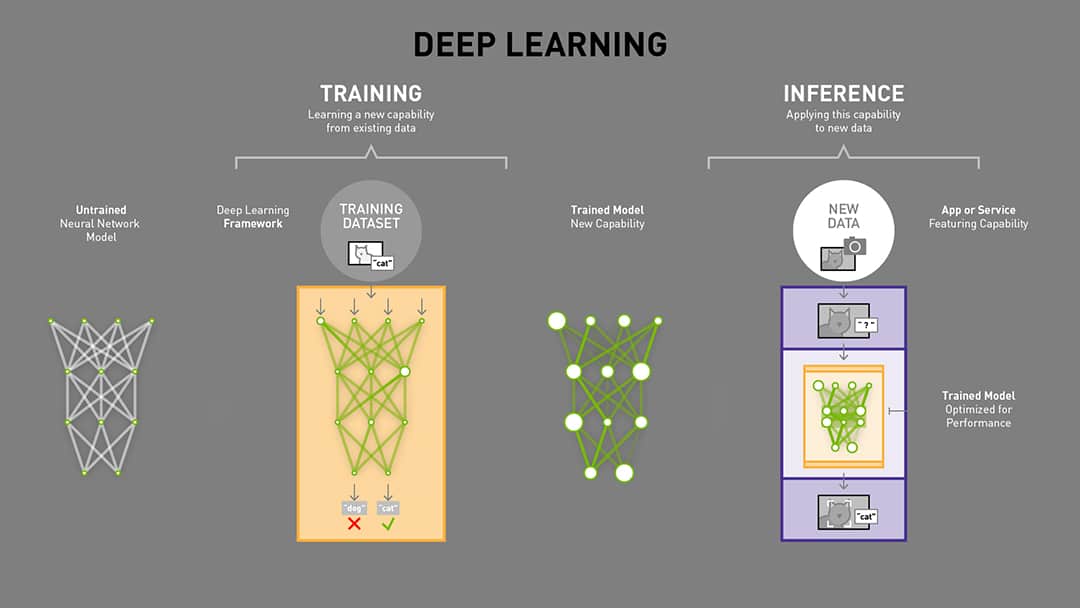
الاستدلال هو عملية تشغيل نموذج الذكاء الاصطناعي بعد تدريبه، أي السماح للنموذج بتحليل بيانات أو مواقف جديدة بناءً على الأنماط التي سبق وتعلمها.
ومن المهم الإشارة إلى أن الاستدلال لا يمكن أن يتم دون تدريب مُسبق؛ إذ لا بد أن يتعلم النموذج الأنماط والعلاقات داخل البيانات قبل أن يتمكن من التنبؤ أو الاستنتاج منها لاحقاً.
يمكن تنفيذ عملية الاستدلال على أنواع مختلفة من العتاد – Hardware، بدءاً من معالجات الهواتف الذكية، مروراً بوحدات معالجة الرسومات – GPUs، وصولاً إلى مسرِّعات الذكاء الاصطناعي المصممة خصيصاً لهذا الغرض.
ومع ذلك، لا تستطيع هذه الأجهزة تشغيل النماذج بنفس الكفاءة، فالنماذج الضخمة قد تستغرق وقتاً طويلاً لتوليد النتائج على حاسوب محمول، مقارنةً بسيرفر سحابي مزود بمعالجات ذكاء اصطناعي متقدمة.
النماذج اللغوية الكبيرة (LLM – Large Language Model)
هي النماذج التي تقف خلف أشهر المساعدين الذكيين، مثل جيميناي، وكلاود، وشات جي بي تي.
عندما تتفاعل مع مساعد ذكاء اصطناعي، فأنت في الواقع تتفاعل مع نموذج لغوي كبير يعالج استفسارك مباشرةً أو عبر أدوات مساعدة مثل التصفح أو تحليل الأكواد.
قد يختلف اسم المساعد الذكي عن اسم النموذج نفسه، على سبيل المثال، GPT هو اسم النموذج من شركة OpenAI، بينما ChatGPT هو اسم المنتج القائم على هذا النموذج.
تُبنى النماذج اللغوية الكبيرة باستخدام شبكات عصبية عميقة تحتوي على مليارات المعاملات الرقمية (المعروفة بالأوزان – Weights)، والتي تتعلم العلاقات بين الكلمات والعبارات لبناء تمثيل لغوي مُعقّد متعدد الأبعاد.
يتم تدريب هذه النماذج عبر تحليل الأنماط داخل كميات هائلة من الكتب والمقالات والنصوص، وعند تلقِّي طلب (Prompt)، يقوم النموذج بتوليد النمط اللغوي الأكثر ترجيحاً بناءً على ما ورد في الطلب، ثم يُحدِّد الكلمة التالية الأكثر احتمالاً، ويكرر العملية كلمةً بعد أخرى حتى تكتمل الإجابة.
تُشير الشبكة العصبية إلى البنية الخوارزمية متعددة الطبقات التي تُعدَّ الأساس لتقنيات التعلم العميق، بل والأساس الأهم وراء الطفرة التي شهدتها أدوات الذكاء الاصطناعي التوليدي بعد ظهور النماذج اللغوية الكبيرة.
ورغم أن فكرة محاكاة ترابطات الدماغ البشري كأساس لتصميم خوارزميات معالجة البيانات تعود إلى أربعينيات القرن الماضي، فإن التحول الحقيقي لم يحدث إلا في السنوات الأخيرة مع تطور قدرات وحدات معالجة الرسوميات – GPUs المُستخدمة في ألعاب الفيديو.
هذه المعالجات أثبتت كفاءة عالية في تدريب خوارزميات ذات طبقات متعددة، وهو ما لم يكن ممكنًا من قبل، مما مكَّن أنظمة الذكاء الاصطناعي المعتمدة على الشبكات العصبية من تحقيق نتائج متقدمة في مجالات متعددة، مثل التعرف الصوتي، القيادة الذاتية، واكتشاف الأدوية.

التدريب (Training)
تطوير أنظمة الذكاء الاصطناعي المعتمدة على التعلم الآلي يتطلب المرور بمرحلة أساسية تُعرف باسم “التدريب”.
ماذا يعني ذلك؟ ببساطة، هي عملية تغذية النموذج بكميات ضخمة من البيانات ليتمكن من التعرُّف على الأنماط الموجودة فيها، ومن ثم إنتاج مخرجات ذات فائدة بناءً على ما تعلَّمه.
وهنا يُصبح الأمر أكثر فلسفية على مستوى بنية الذكاء الاصطناعي؛ إذ إن النموذج قبل التدريب لا يكون أكثر من طبقات رياضية مكوَّنة من أرقام عشوائية.
التدريب هو ما يُشكّل هذا النموذج ويمنحه القدرة على التعلُّم فعلياً. وهو في جوهره عملية تكيُّف مستمرة، يَستجيب فيها النظام لخصائص البيانات ويتعلم كيف يُنتج مخرجات أقرب إلى الهدف المطلوب، سواءً كان ذلك التعرُّف على صور القطط أو كتابة هايكو حسب الطلب.
الجدير بالذكر أن أنظمة الذكاء الاصطناعي لا تتطلب جميعها تدريباً، فهناك أنظمة قائمة على القواعد (Rules-based AIs)، تُبرمج يدوياً وفق منطق محدد مسبقاً، مثل بعض روبوتات الدردشة الخطية، وهذه لا تحتاج إلى تدريب، لكنها، في المقابل، تكون أقل مرونة وكفاءة مقارنةً بالأنظمة الذاتية التعلم التي تم تدريبها بشكل جيد.
ومع ذلك، فإن عملية التدريب قد تكون مكلفة، لأنها تحتاج إلى كميات هائلة من البيانات، وقدرات حوسبة كبيرة، ووقت طويل، خصوصاً مع الاتجاه المتصاعد نحو نماذج أضخم وأعمق.
ولهذا، تظهر مقاربات هجينة – Hybrid Approaches لتسريع عملية تطوير النماذج وتقليل التكاليف، من هذه الأساليب إجراء ضبط دقيق مدفوع بالبيانات – Data-driven Fine-tuning على نموذج ذكاء اصطناعي قائم على القواعد، ما يوفِّر في الموارد مقارنةً ببناء نموذج جديد كلياٍ من الصفر.

التعلم النقلي (Transfer Learning)
التعلم النقلي هو تقنية تُستخدم لإعادة توظيف نموذج ذكاء اصطناعي تم تدريبه مُسبقاً كنقطة انطلاق لتطوير نموذج جديد غالبًا لأداء مهمة مختلفة ولكن ذات صلة، حيث تسمح هذه المقاربة بإعادة استخدام المعرفة التي اكتسبها النموذج خلال دورات التدريب السابقة.
يساهم التعلم النقلي في تقليص الوقت والتكلفة اللازمة لتطوير النماذج، كما يمكن أن يكون مفيداً في الحالات التي تكون فيها البيانات المتاحة للمهمة الجديدة محدودة.
ومع ذلك، من المهم الإشارة إلى أن حدود هذا النهج، فالنماذج التي تُطوَّر باستخدام التعلم النقلي بهدف تحقيق أداء عام، قد تظل بحاجة إلى تدريب إضافي على بيانات مخصصة للمجال المستهدف حتى تُحقِّق نتائج دقيقة وفعالة.

الأوزان (Weights)
تُعد من العناصر الجوهرية في تدريب نماذج الذكاء الاصطناعي، فهي التي تُحدِّد مقدار الأهمية الذي يُعطى لكل ميزة (أو متغيِّر) في مجموعة البيانات المُستخدمة للتدريب، وبالتالي، تُشكِّل مخرجات النموذج واتجاهاته.
وبصياغة أخرى، فإن الأوزان هي معاملات رقمية تُستخدم لتحديد ما هو الأكثر بروزاً أو تأثيراً في البيانات بالنسبة للمهمة التدريبية، وتؤدي وظيفتها من خلال ضرب هذه القيم بالمدخلات.

عادةً ما يبدأ التدريب بأوزان عشوائية، ثم تُعدَّل تدريجياً خلال العملية للاقتراب من النتائج المرجوة.
على سبيل المثال، في نموذج ذكاء اصطناعي يُستخدم لتوقّع أسعار العقارات، ويتم تدريبه على بيانات سوق العقارات في منطقة معينة، قد تتضمن الأوزان ميزات مثل عدد غرف النوم والحمامات، وما إذا كان المنزل مستقلاً أم لا، إضافة إلى توافر موقف للسيارات، وغيرها.
في النهاية، تعكس الأوزان التي يُعيِّنها النموذج لكل من هذه الخصائص مدى تأثير كل منها على قيمة العقار، استناداً إلى البيانات التي تم تدريبه عليها.
المصادر:


